Cette page concerne comment la parole est générée: clips concaténatifs, vocodeurs paramétriques, audio brut de type WaveNet et les modèles neuronaux utilisés aujourd'hui par GSpeech. Il ne s'agit pas d'une liste expliquant « pourquoi ajouter un lecteur » ; ce sujet est abordé ultérieurement. avantages du site web TTSIl ne s'agit pas non plus d'un guide d'installation de WordPress.
Sur un site en production, vous ne choisissez pas un document de recherche. Vous choisissez une voix dans la console cloud. Sous ce choix, le Moteur vocal IA unifié (À des fins commerciales) : utilisation possible d’OpenAI, Gemini, Google Cloud, Chirp3 HD, Neural2, Polyglot et WaveNet – aucune clé API requise. Le traitement dans le cloud évite toute charge serveur et préserve ainsi votre infrastructure.
Le processus de synthèse (ce qui se passe réellement)
Synthèse de discours Il transforme les jetons écrits en une forme d'onde. Un lecteur web n'est que la dernière étape : la lecture d'un fichier. Le plus intéressant se situe en amont.
- Texte en — Article isolé, segment surligné (RHT) ou chaîne traduite. L’isolation relève du travail de production, et non d’un document de vocodeur.
- Analyse linguistique — mots, accentuation, pauses. Les alias de prononciation intelligente se trouvent ici : chaînes de caractères que le modèle devinerait autrement.
- Modèle acoustique - des unités de concaténation, un vocodeur paramétrique ou un réseau neuronal qui prédit l'audio.
- Sortie de forme d'onde - Stocké une seule fois sous « Générer une fois, conserver et lire », puis diffusé en continu. Navigateur speechSynthesis Il ignore ce magasin et utilise celui fourni avec le système d'exploitation.
Trois familles de modèles TTS
Synthèse vocale concaténative Il stocke de courts extraits audio et les recombine. Changer d'intervenant ou d'émotion implique généralement l'enregistrement d'une nouvelle base de données. Les systèmes de type Siri classiques utilisaient ce principe.
Synthèse vocale paramétrique conserve les caractéristiques de la parole dans les paramètres du modèle. Les premières versions sonnaient souvent moins naturelles que la concaténation car l'audio passait par un vocodeur.
Les systèmes neuronaux s'appuient sur cette histoire. Les algorithmes basés sur des règles et les modèles statistiques sont toujours présents dans les manuels. Ce que vous entendez sur les voix commerciales de GSpeech est une synthèse vocale réalisée par IA : OpenAI, Gemini, Google Cloud Neural2/Polyglot/Chirp3 HD et WaveNet – et non une banque de voix locale concaténée hébergée sur votre serveur PHP.
WaveNet : modélisation du signal brut
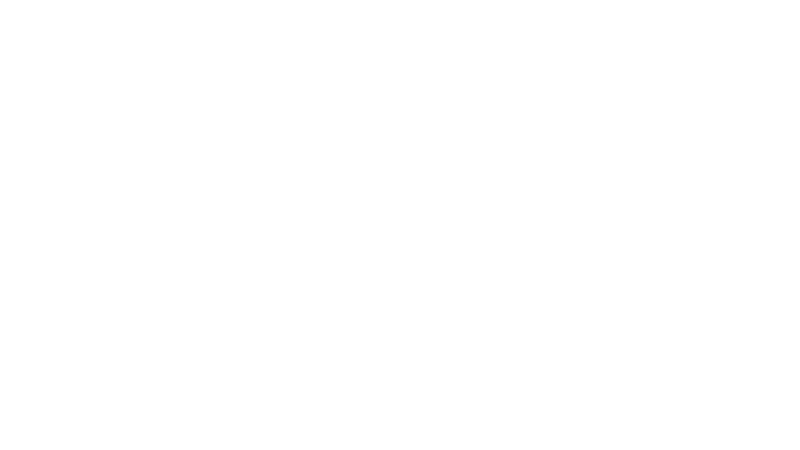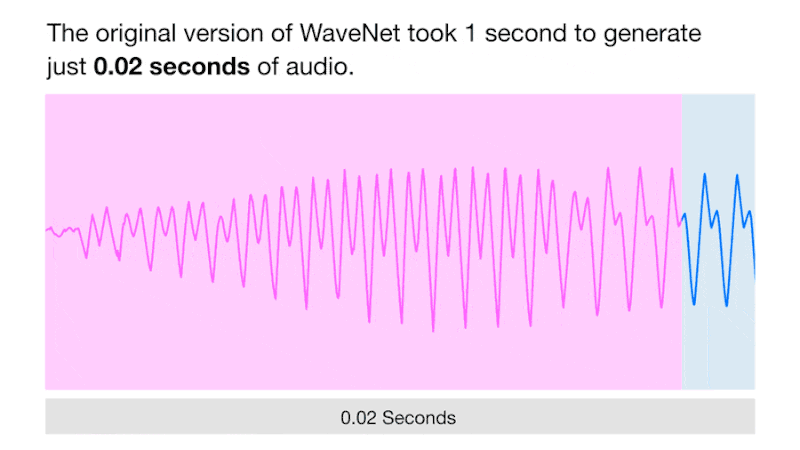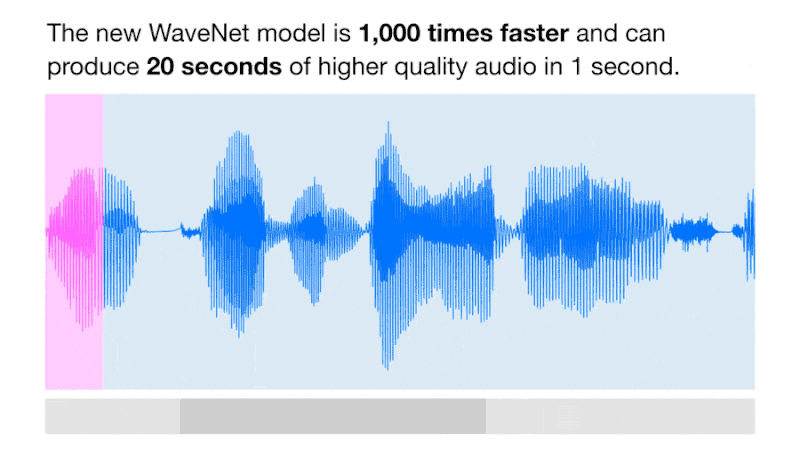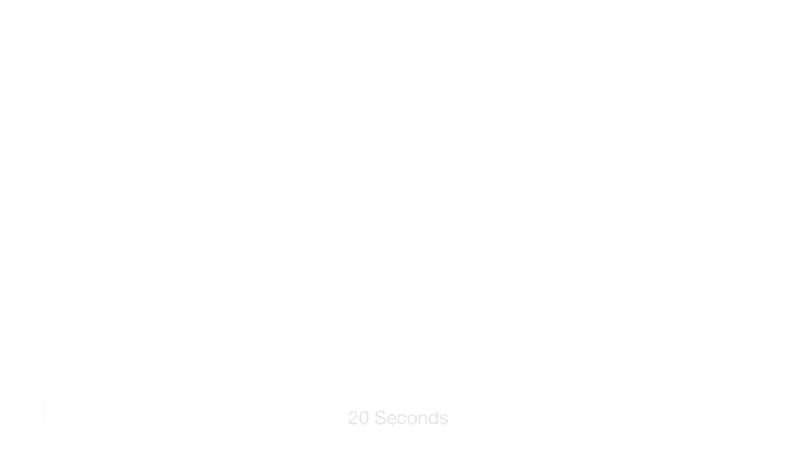
WaveNet a révolutionné le traitement paramétrique en prédisant le signal audio échantillon par échantillon, au lieu de fournir un spectrogramme compact à un vocodeur. Les travaux de Google de 2016 ont démontré qu'un réseau de neurones convolutif dilaté pouvait couvrir des milliers d'instants. L'audio brut étant dense (généralement 16 000 échantillons par seconde, voire plus), la génération autorégressive est coûteuse, mais elle permet de capturer les bruits de bouche et les particularités du locuteur que la méthode de concaténation ne parvient souvent pas à saisir.
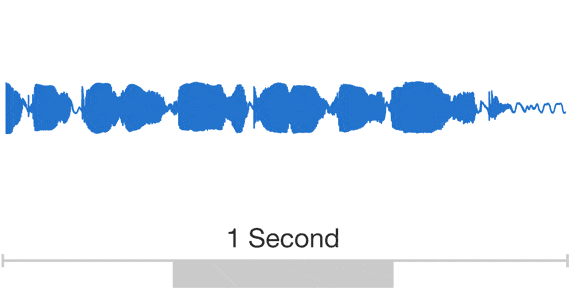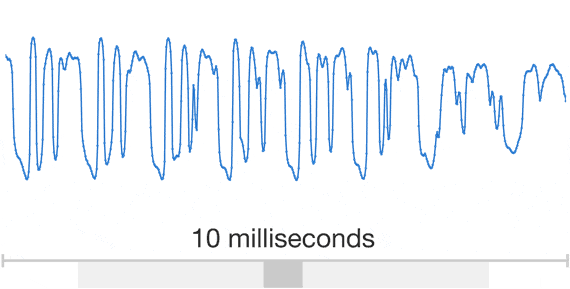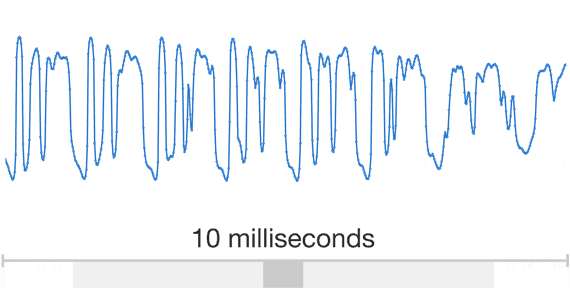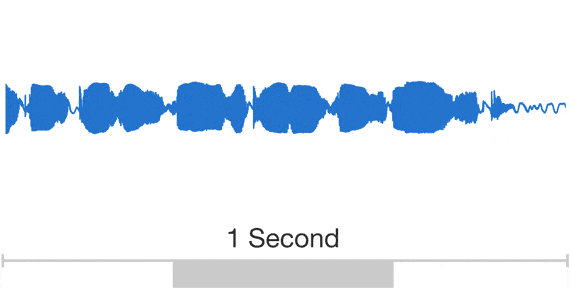
PixelRNN et PixelCNN Cette étude a démontré qu'il était possible de générer une image canal par canal. WaveNet est la version unidimensionnelle de cette idée : un réseau entièrement convolutionnel dont les facteurs de dilatation augmentent le champ réceptif de manière exponentielle.
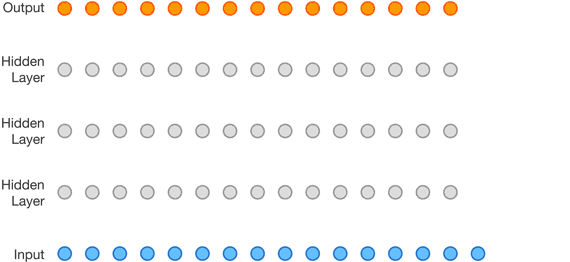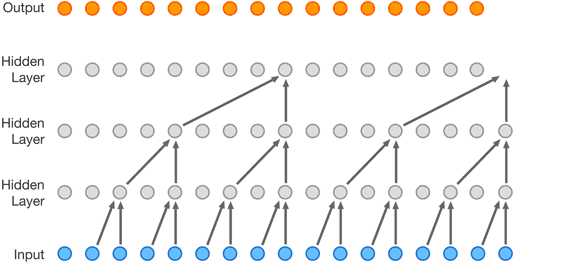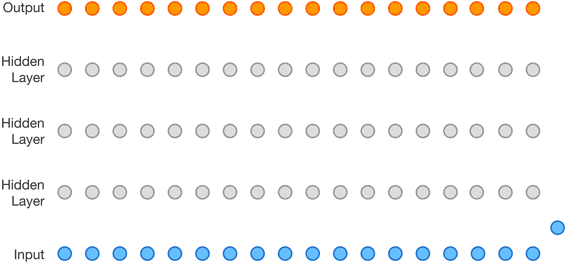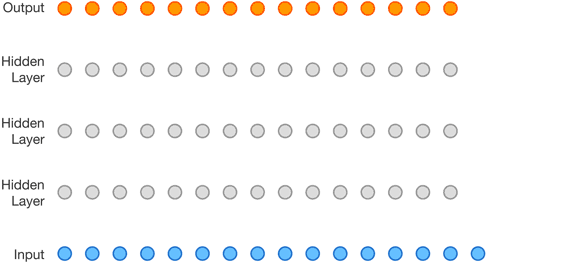
Lors de l'entraînement, les entrées sont des signaux enregistrés. Lors de l'échantillonnage, chaque étape prélève un échantillon de la distribution prédite par le réseau, le réinjecte et poursuit le processus. C'est pourquoi les premières versions de WaveNet étaient réservées à la recherche ; les versions ultérieures l'ont adapté pour la production, notamment pour le système de synthèse vocale de Google.
MOS et l'écart de 2016
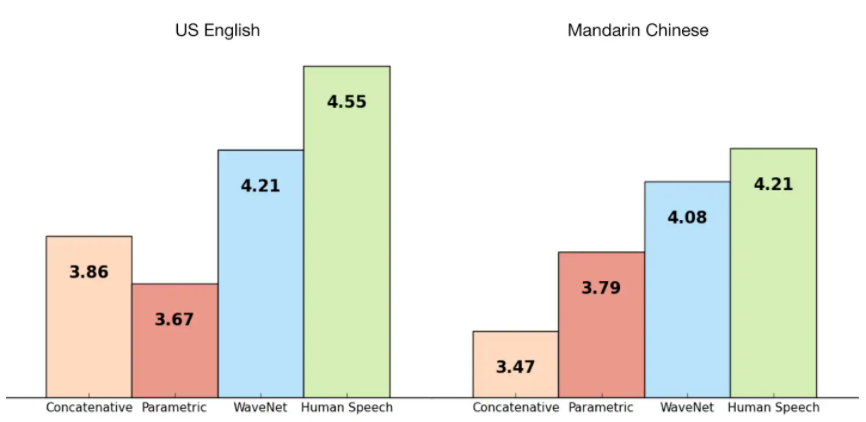
Google a évalué WaveNet par rapport aux meilleurs systèmes paramétriques et concaténatifs de l'époque, en utilisant Scores moyens d'opinion (MOS) — Évaluations humaines à l'aveugle (plus de 500 évaluations sur 100 phrases de test dans le rapport initial). WaveNet a réduit de plus de moitié l'écart restant avec la parole humaine pour l'anglais américain et le mandarin dans ces tests. Il s'agit d'une avancée majeure pour la recherche, et non d'un argument marketing pour GSpeech.
WaveNet fait partie de la famille Unified AI Voice Engine. Piles ultérieures - Gemini TTS, Chirp3 HDNeural2, Polyglot et OpenAI sont les voix que vous sélectionnez dans la console Cloud. Vous ne déployez pas de point de contrôle WaveNet sur WordPress.
Gemini TTS : synthèse vocale contrôlée par invite
WaveNet a prédit l'échantillon audio suivant. Gemini TTS GSpeech est une méthode de génération vocale plus récente de Google : vous décrivez comment la lecture doit sonner en langage naturel (style, accent, rythme, ton, émotion, débit) et le modèle s'exécute. C'est pourquoi GSpeech messages vocaux personnalisés et Vibrations vocales (Ce sont les styles, et non les identifiants vocaux supplémentaires) qui importent sur Gemini : le contrôle se trouve dans l’invite, et non dans une nouvelle banque concaténative.
Le nettoyage linguistique est toujours effectué en premier. Les alias de prononciation intelligents peuvent développer un acronyme ou verrouiller un jeton de marque ; Gemini prononce ensuite la chaîne préparée avec le format demandé. Notes de l’API officielle : Gemini TTS.
Narration Gemini haute fidélité lorsque le bouton d'écoute fait partie de la page : articles phares, explications de marque, descriptions de produits.
Le même langage d'invite que dans la version Pro, optimisé pour une génération plus rapide dans un catalogue d'articles ou de références.
Gemini Pro
Gemini Pro Gemini TTS, le modèle ultra-réaliste intégré à GSpeech, vous permet de personnaliser votre message vocal comme vous le feriez pour un narrateur : une explication produit plus posée, un article de blog plus dynamique, un accent plus marqué, un débit plus lent et une émotion plus intense. Le code HTML reste propre pour les lecteurs et le référencement naturel. Aucune clé Gemini supplémentaire, aucun projet Google AI Studio ni console de fournisseur additionnelle ne sont nécessaires.
Techniquement, il s'agit toujours de synthèse dans le cloud, puis d'un fichier enregistré. Les écoutes répétées correspondent à une lecture, et non à un nouvel aller-retour Gemini. Utilisez la version Pro lorsque l'audio est au cœur de l'expérience : par exemple, pour un article phare ou une page produit où la présentation doit être ciblée et non générique.
Gemini Flash
Gemini Flash Il s'agit de la même famille Gemini TTS, conçue pour la rapidité. Le vocabulaire des prompts correspond à celui de la version Pro (style, accent, rythme, ton, émotion, débit), ce qui vous permet de rédiger une indication vocale une seule fois et de la réutiliser, tandis que Flash génère des pages plus rapidement. Un outil puissant pour les catalogues : nombreux articles, descriptions WooCommerce, brouillons multilingues. Optimisez les performances en affichant une URL principale en version Pro.
Chirp3 HD: Google Cloud’s current HD neural family
Chirp3 HD Il ne s'agit pas de « WaveNet rebaptisé ». WaveNet (2016) modélisait l'audio brut à l'aide de convolutions dilatées. Les voix Neural2, Polyglot et WaveNet sont toujours disponibles dans le catalogue Google Cloud. 230 (étage : Standard, WaveNet, Neural2, Polyglot, Journey, Studio, News). Chirp3 HD est la dernière génération de synthèse vocale haute définition de Google dans le cloud ; elle est conçue pour offrir un réalisme et une intonation naturelle plutôt qu’une lecture à voix haute plate. Notes officielles : Chirp 3 HD.
Dans GSpeech, Chirp3 HD est une voix de la console cloud : aucun projet Google Cloud, aucun fichier JSON de compte de service. Vous choisissez la voix ; la synthèse s'effectue à partir de votre source ; le fichier est stocké et lu via Pleine page, Bouton, Cercle, Flottant, Contexte ou RHT. La vitesse et la hauteur restent dans la console. Les noms de marque restent dans les alias de prononciation intelligente ; cette couche est indépendante de la famille Google que vous avez choisie.
Quand choisir Chirp3 HD ou Gemini : Chirp3 HD lorsque vous souhaitez une qualité neuronale HD de Google Cloud pour la production et une lecture cohérente quel que soit l’appareil. Gemini Pro/Flash lorsque vous souhaitez un contrôle précis du style et des émotions des invites en langage naturel. Les deux sont des solutions commerciales de moteur vocal IA unifié. Le total du moteur est de 300+ voix à travers 98 langues (Gemini : environ 30 × 3 pour Chirp 3 HD, Flash et Pro par langue, plus OpenAI 11 × 2, plus le catalogue Google Cloud). Les Voice Vibes sont des styles, pas des identifiants supplémentaires.
- Neural2 - des voix neuronales de production largement utilisées dans le même catalogue Google Cloud.
- Polyglotte - de meilleures performances multilingues/interlinguistiques.
- WaveNet - la famille de formes d'onde brutes de 2016, toujours disponible en tant que voix de catalogue, n'est pas la seule voie possible chez Google.
Moteur vocal IA unifié vs synthèse vocale du navigateur
Appareil speechSynthesis Il s'agit d'une API locale. Les voix varient selon le système d'exploitation. Il n'y a pas de fichier « Générer une fois, conserver et lire », pas de synchronisation audio intelligente lors des modifications du CMS, ni de couche d'invite vocale Voice Vibes. GSpeech Cloud Processing exécute le modèle dans le cloud, stocke le fichier et le widget le lit. Les problèmes de génération temporaires ne suppriment pas les fichiers précédemment générés. Les fichiers ne sont pas supprimés lorsqu'un compte repasse au forfait gratuit. La nouvelle génération reste soumise au forfait actif.
models:  "OpenAI, Gemini, Google Cloud, Chirp3 HD, Neural2, Polyglot, WaveNet"
langs:    "98 languages, 300+ voices (commercial)"
control: "Voice Vibes + Smart Pronunciation Aliases"
keys:    "No API Keys Required"
Les vibrations vocales (commerciales) sont de type vocal, et non une nouvelle banque de voix concaténées. Les alias permettent de corriger la prononciation d'un jeton sans modifier le code HTML visible. Ces deux éléments constituent des couches de contrôle superposées au modèle acoustique sélectionné par le moteur pour cette voix.
FAQ sur la technologie de synthèse vocale
Modèles et pipelines - pas de configuration de plugins.
-
GSpeech utilise-t-il WaveNet à chaque écoute ?
Non. WaveNet fait partie de la famille Google, qui comprend plusieurs modules. Le moteur vocal IA unifié prend également en charge Neural2, Polyglot, Chirp3 HD, Gemini et OpenAI selon la voix sélectionnée. L'option « Générer une fois, conserver et lire » signifie que les lectures répétées utilisent le fichier enregistré, et non une nouvelle boucle d'échantillons générée pour la recherche.
-
Pourquoi parle-t-on encore de synthèse vocale concaténative ?
Il s'agit du point de départ historique : assembler des unités enregistrées. Les modèles neuronaux génèrent du son au lieu de coller des syllabes. Comprendre la différence entre la concaténation et WaveNet explique pourquoi les voix commerciales modernes peuvent changer de style sans nouvelle session d'enregistrement.
-
Puis-je exécuter ces modèles sur mon propre serveur ?
Le service proposé par le site web de GSpeech est un traitement cloud sans charge serveur. Vous n'hébergez ni WaveNet, ni Gemini, ni OpenAI sur WordPress. Aucune clé API n'est requise : la facturation et les clés restent dans la console cloud.
-
Les critères MOS de 2016 sont-ils toujours valables pour GSpeech aujourd'hui ?
Le graphique MOS présenté sur cette page correspond à l'évaluation WaveNet publiée par Google. GSpeech ne revendique pas ce même score pour toutes les voix actuelles. La qualité commerciale actuelle dépend de la combinaison de moteurs de synthèse vocale mentionnée ci-dessus, et non d'une simple reproduction du score MOS de 2016.
-
Gemini Pro vs Gemini Flash - quelle est la différence ?
Même famille de voix de synthèse Gemini et même langue d'invite vocale personnalisée (style, accent, rythme, ton, émotion, débit). Flash est plus rapide pour les catalogues ; Pro offre une meilleure fidélité pour les pages phares. Aucune des deux ne nécessite de clé API Gemini dans GSpeech : vous choisissez la voix dans la console Cloud.
-
Chirp3 HD est-il identique à WaveNet ?
Non. WaveNet est la famille de modèles de formes d'onde brutes de Google, datant de 2016. Chirp3 HD est une génération TTS cloud haute définition plus récente, offrant un réalisme et une intonation supérieurs. Les voix Neural2, Polyglot et WaveNet sont toujours disponibles dans le catalogue Google Cloud (plus de 230). GSpeech propose Chirp3 HD comme voix de console, sans projet Google Cloud.
Du papier à la voix dans la console
Les banques de vocodeurs concaténées, les vocodeurs paramétriques et le pari sur la forme d'onde brute de WaveNet en sont les héritiers. Gemini TTS (Pro/Flash) ajoute la lecture guidée par invite ; Chirp3 HD est la famille neuronale HD actuelle de Google Cloud. Sur un site GSpeech, vous pouvez entendre le moteur vocal IA unifié actuel via un widget : Pleine page, Bouton, Cercle ou Lire le texte surligné (RHT) Les fichiers sont conservés après la première génération. Pour savoir si votre URL doit inclure un lecteur, consultez l'article sur les avantages. Pour les clics dans l'interface d'administration WordPress, consultez le guide pratique.
